Data Cleaning: Hər səhv görünən məlumatı silmək doğrudurmu?
Data analitikləri üçün məlumatların təmizlənməsi və düzgün qərarvermə üsulları
Məlumatlar düzgün deyilsə, analiz nə qədər etibarlı ola bilər?
Təsəvvür edək ki, bir texniki servis şirkətinin müştəri müraciətlərini təhlil edirik. Məqsədimiz müraciətlərin orta həll müddətini hesablamaq, xidmət keyfiyyətini qiymətləndirmək və rəhbərlik üçün hesabat hazırlamaqdır. Məlumatları əldə etdikdən sonra bəzi problemlərlə qarşılaşırıq: eyni müraciət nömrəsi bir neçə dəfə təkrarlanır, müəyyən xidmətlərin tamamlanma tarixi boşdur, bəzi müraciətlər digərlərindən xeyli uzun müddətə həll edilib.
İlk baxışda bu məlumatları təmizləyərək problemləri aradan qaldırmaq lazım olduğunu düşünə bilərik. Amma həmin qeydlərin hamısı doğrudanmı səhvdir?
Məsələn, eyni müştərinin müraciəti sistemdə üç dəfə göstərilirsə, bu, texniki təkrarlanma da ola bilər, müraciətin müxtəlif mərhələlərini əks etdirən üç fərqli qeyd də.
Məhz bu səbəbdən Data Cleaning prosesində əsas məsələ yalnız səhvləri tapmaq deyil, onların səbəbini başa düşməkdir.
Data Cleaning nədir?
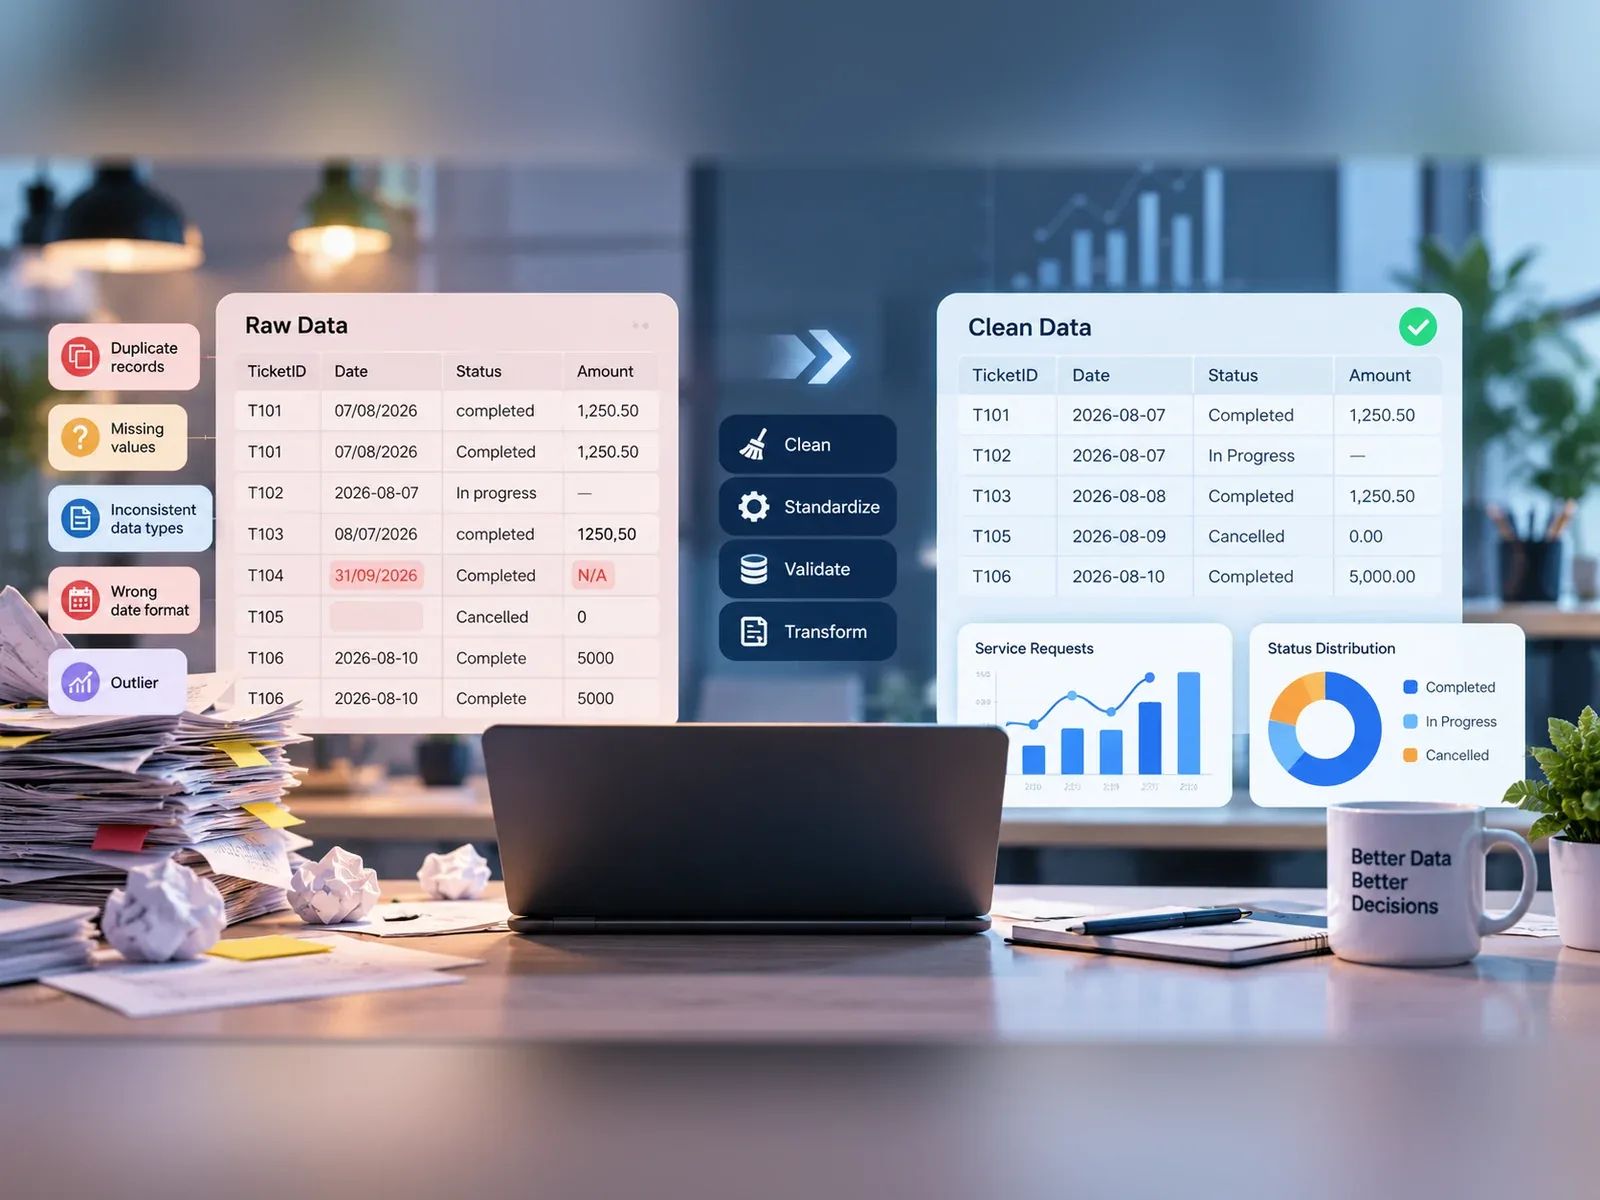
Data Cleaning məlumatlarda mövcud olan səhvlərin, uyğunsuzluqların, çatışmayan və təkrarlanan dəyərlərin müəyyənləşdirilməsi, qiymətləndirilməsi və uyğun qaydada emal edilməsi prosesidir.
IBM-in məlumatların təmizlənməsinə dair yanaşmasında beş əsas istiqamət fərqləndirilir: standartlaşdırma (Standardization), kənar müşahidələrin idarə edilməsi (Outliers), təkrarlanan qeydlərin aradan qaldırılması (Deduplication), çatışmayan dəyərlərin emalı (Missing Values) və məlumatların yoxlanılması (Validation) [1].
Lakin təmizlənmiş məlumatın keyfiyyətli olması yalnız texniki səhvlərin aradan qaldırılması ilə ölçülmür.
Böyük Britaniya hökumətinin Data Quality Framework sənədində məlumat keyfiyyəti altı əsas meyarla qiymətləndirilir: Accuracy, Completeness, Consistency, Uniqueness, Validity və Timeliness [2].
Sadə dillə desək, məlumat doğru, kifayət qədər tam, ardıcıl, tələb olunan hallarda unikal, müəyyən edilmiş qaydalara uyğun və vaxt baxımından aktual olmalıdır.
Burada vacib bir prinsip var: məlumatın keyfiyyəti onun hansı məqsədlə istifadə olunmasından da asılıdır.
Məsələn, müştərinin telefon nömrəsinin olmaması satışların ümumi məbləğini hesablamağa mane olmaya bilər. Amma müştərilərlə əlaqə saxlamaq üçün həmin məlumat kritik əhəmiyyət daşıya bilər.
1. Duplicate Data: Təkrarlanan məlumatlar həmişə səhvdirmi?
Təkrarlanan qeydlər data analitiklərinin tez-tez rastlaşdığı problemlərdəndir. Lakin hər təkrarlanan dəyəri silmək düzgün deyil.
Texniki servis nümunəmizə qayıdaq.
TicketID Status Tarix
T101 Created 01.09.2026
T101 Progress 02.09.2026
T101 Resolved 04.09.2026
Burada TicketID üç dəfə təkrarlanır. Ancaq bu, üç eyni müraciət demək deyil. Sistem bir müraciətin müxtəlif statuslarını qeydə alıb. Əgər biz sadəcə TicketID əsasında təkrarlanan sətirləri silsək, müraciətin hansı mərhələlərdən keçdiyi haqqında məlumatı itirəcəyik. Əksinə, eyni EventID, status və vaxt göstəricisinə malik qeyd texniki xəta nəticəsində iki dəfə yüklənibsə, ikinci qeydin çıxarılması əsaslandırıla bilər.
Bu səbəbdən təkrarlanan məlumatları silməzdən əvvəl iki sualı cavablandırmaq lazımdır:
- Hər sətir ayrıca əməliyyatı, yoxsa eyni əməliyyatın fərqli mərhələsini ifadə edir?
- Təkrarlanmanın səbəbi məlumatın strukturu, yoxsa texniki xətadır?
Praktik yanaşma: SQL-də GROUP BY və HAVING COUNT(*) > 1, Python-da duplicated(), Power Query-də isə Keep Duplicates vasitəsilə şübhəli qeydləri müəyyənləşdirmək mümkündür.
Amma bu funksiyaların nəticəsi avtomatik silinmə qərarı üçün kifayət etmir. Əvvəlcə qeydlərin biznes mənası yoxlanılmalıdır.
2. Missing Values: Boş xanaları nə vaxt doldurmalıyıq?
Təsəvvür edək ki, servis məlumatlarında bəzi müraciətlərin tamamlanma tarixi boşdur.
İlk baxışda bu, çatışmayan məlumat kimi görünür. Ancaq həmin müraciətlərin statusu In Progress olarsa, tamamlanma tarixinin boş olması tamamilə normaldır. Digər tərəfdən, statusu Resolved olan müraciətin tamamlanma tarixi boşdursa, burada məlumat keyfiyyəti problemi ola bilər. Deməli, eyni sütundakı boş dəyərlər fərqli məna daşıya bilər. Missing Values ilə işləyərkən əsasən üç yanaşmadan istifadə edilir:
Silinmə: Çatışmayan məlumat müəyyən analiz üçün vacibdirsə və onu bərpa etmək mümkün deyilsə, həmin müşahidə konkret hesablamadan çıxarıla bilər.
Əvəzləmə (Imputation): Müəyyən statistik və proqnozlaşdırma məsələlərində boş dəyərlər orta, median və ya digər əsaslandırılmış üsullarla əvəz edilə bilər.
Saxlanılma: Boş dəyər özü informasiya daşıyırsa, onu olduğu kimi saxlamaq və ya ayrıca işarələmək daha məqsədəuyğundur.
Məsələn, müştərinin faktiki ödədiyi məbləğ məlum deyilsə, həmin məbləği bütün müştərilərin orta ödənişi ilə doldurmaq maliyyə nəticələrini təhrif edə bilər. Lakin proqnozlaşdırma modelində bəzi dəyişənlər üçün statistik əvəzləmə uyğun yanaşma ola bilər.
Burada başqa bir mühüm fərq də var:
0 dəyərin sıfır olduğunu, NULL isə dəyərin mövcud olmadığını və ya məlum olmadığını göstərə bilər.
Bunları eyniləşdirmək hesablamaların nəticəsini dəyişə bilər.
3. Outliers: Qeyri-adi göstəricini niyə dərhal silməməliyik?
Servis şirkətimizin tamamlanmış müraciətlər üzrə həll müddətləri aşağıdakı kimidir:
Müraciət Həll müddəti
T201 2 gün
T202 3 gün
T203 4 gün
T204 21 gün
Məlumatlara əsasən orta həll müddəti 7,5 gün, median isə 3,5 gündür.
Sonuncu müraciət digər göstəricilərdən xeyli fərqlənir. Bəs onu silmək lazımdırmı?
Araşdırma nəticəsində məlum olur ki, həmin müraciətin uzun müddət davam etməsinin səbəbi xaricdən ehtiyat hissəsinin sifariş edilməsi olub. Yəni burada texniki səhv yoxdur. Əksinə, həmin müşahidə şirkətin fəaliyyətində mövcud olan vacib problemi göstərir. Əgər bu qeydi silsək, orta həll müddəti 3 günə düşəcək. Nəticədə şirkətin xidmət performansı olduğundan daha yaxşı görünə bilər. NIST-in statistik metodologiyasında da vurğulandığı kimi, qeyri-adi müşahidələr səhv məlumatlardan qaynaqlana bildiyi kimi, real və əhəmiyyətli hadisələri də əks etdirə bilər [3].
Bu səbəbdən outlier-ləri müəyyən etmək üçün IQR, Z-score və digər statistik üsullardan istifadə etsək də, onların silinməsi qərarını yalnız statistik sərhədlər əsasında verməməliyik.
Bizim nümunədə ən faydalı yanaşma 21 günlük müraciəti saxlamaq, orta ilə yanaşı medianı da hesablamaq və gecikmənin səbəbini ayrıca təhlil etməkdir.
Əsas prinsip: Outlier-i aşkar etmək statistik məsələdir, onunla nə etmək isə həm statistik, həm də biznes qərarıdır.
4. Data Types və tarix formatları: Düzgün məlumat necə yanlış nəticəyə çevrilir?
Bəzən məlumatın özündə heç bir səhv olmur, lakin proqram onu yanlış interpretasiya edir.
Məsələn, servis şirkətimiz müxtəlif ölkələrdən məlumat alır və tarixlər aşağıdakı formatlarda saxlanılır:
- 07/08/2026
- 2026-08-07
- 08/07/2026
Birinci dəyərin 7 avqust, yoxsa 8 iyul olduğunu mənbə formatını bilmədən dəqiq müəyyən etmək mümkün deyil. Tarix səhv çevrilərsə, müraciət başqa hesabat ayına düşə, xidmət müddəti və aylıq performans göstəriciləri yanlış hesablana bilər. Oxşar problem məbləğlərdə də yaranır. Məsələn, 1.250,50 və 1,250.50 eyni məbləği ifadə edə bilər, lakin regional formatlar fərqli olduğu üçün hər iki dəyər eyni qaydada emal edilməyə bilər. Digər mühüm nüans identifikatorlarla bağlıdır. 000457 şəklində saxlanılan müştəri kodunu tam ədədə çevirsək, başlanğıcdakı sıfırlar itə bilər. Buna görə hər rəqəm kimi görünən məlumatı ədəd formatına çevirmək düzgün deyil.
Məlumatların standartlaşdırılması zamanı əsas diqqət onların zahiri görünüşünə deyil, hansı biznes mənasını ifadə etməsinə yönəlməlidir.
5. Təmizlənmiş məlumatın düzgün olduğunu necə yoxlayaq?
Data Cleaning prosesini müəyyən funksiyaları tətbiq etməklə yekunlaşdırmaq olmaz. Əsas məsələ edilən dəyişikliklərin nəticəsini yoxlamaqdır.
Məncə, hər bir data analitiki hesabatı təqdim etməzdən əvvəl aşağıdakı beş sualı cavablandırmalıdır:
- Row Count: İlkin və təmizlənmiş məlumatlarda sətir sayı nə qədər dəyişib və niyə?
- Duplicate Check: Təkrarlanan qeydlər həqiqətən eyni əməliyyatları ifadə edirdimi?
- Missing Values: Boş dəyərlər hansı qaydaya əsasən saxlanılıb, əvəz edilib və ya analizdən çıxarılıb?
- Business Rules: Mənfi məbləğlər, qeyri-adi göstəricilər və tarixlər biznes proseslərinə uyğun olaraq yoxlanılıbmı?
- Reconciliation: Təmizləmədən əvvəl və sonra əsas KPI-larda yaranan fərqlərin səbəbini izah edə bilirikmi?
Burada Data Profiling alətləri də köməyimizə çatır.
Məsələn, Microsoft Power Query-nin Column Quality, Column Distribution və Column Profile funksiyaları vasitəsilə sütunlardakı boş, xətalı və fərqli dəyərləri qiymətləndirmək mümkündür [4].
Lakin diqqət yetirməli olduğumuz məqamlardan biri də budur ki, Power Query standart olaraq məlumatların profillənməsini ilk 1 000 sətir əsasında həyata keçirə bilər. Tam məlumat dəstini yoxlamaq üçün profilin bütün sətirlərə tətbiq olunmasını seçməliyik.
Python-da isə pandas kitabxanasının isna(), duplicated(), dropna() və fillna() funksiyaları bu prosesin bir çox mərhələsini avtomatlaşdırmağa imkan verir [5].
Bununla belə, avtomatlaşdırılmış təmizləmə qaydalarının da yoxlanılması vacibdir. Yanlış qurulmuş bir qayda hər yeni məlumat yüklənməsində eyni səhvi təkrarlaya bilər.
Nəticə: Təmiz məlumat həmişə az məlumat demək deyil
Data Cleaning prosesində ən böyük yanlış yanaşmalardan biri bütün uyğunsuz və qeyri-adi dəyərləri məlumat bazasından çıxarmağa çalışmaqdır.
Halbuki real iş mühitində bəzən boş dəyər normal biznes prosesini, təkrarlanan qeyd əməliyyatın tarixçəsini, outlier isə diqqətdən yayınan mühüm problemi göstərir.
Buna görə məlumatları təmizləyərkən dörd əsas qərar arasında seçim etməliyik: silmək, düzəltmək, saxlamaq və ya əlavə araşdırma üçün işarələmək.
Seçdiyimiz yanaşma məlumatın strukturuna, biznes mənasına və aparacağımız analizin məqsədinə uyğun olmalıdır.
Eyni zamanda, etdiyimiz dəyişiklikləri sənədləşdirməli və ilkin məlumatların dəyişdirilməmiş versiyasını saxlamalıyıq. Belə olduqda nəticələrin doğruluğunu sonradan yoxlamaq və hesabatlar arasında yaranan fərqləri izah etmək daha asan olur.
Yekunda bir məqamı xüsusi vurğulamaq istərdim: yaxşı data analitiki yalnız səhvləri aşkar edən deyil, hansı məlumatın niyə dəyişdirilməli olduğunu əsaslandıra bilən şəxsdir.
Çünki məqsədimiz sadəcə daha səliqəli cədvəl hazırlamaq deyil, real vəziyyəti düzgün əks etdirən və etibarlı qərarlar verməyə imkan yaradan məlumatlarla işləməkdir.
İstifadə olunan mənbələr
- IBM Think. What Is Data Cleaning? — Data Cleaning anlayışı, əsas metodlar, məlumatların standartlaşdırılması və yoxlanılması.
- https://www.ibm.com/think/topics/data-cleaning
- Government Data Quality Hub, UK Government (2020). The Government Data Quality Framework. — Məlumat keyfiyyətinin əsas meyarları və qiymətləndirilməsi.
- https://www.gov.uk/government/publications/the-government-data-quality-framework/the-government-data-quality-framework
- NIST/SEMATECH. e-Handbook of Statistical Methods: Detection of Outliers. — Kənar müşahidələrin müəyyənləşdirilməsi və idarə olunmasının statistik əsasları.
- https://itl.nist.gov/div898/handbook/eda/section3/eda35h.htm
- Microsoft Learn. Using the Data Profiling Tools — Power Query. — Məlumat keyfiyyətinin praktiki qiymətləndirilməsi və profillənməsi.
- https://learn.microsoft.com/en-us/power-query/data-profiling-tools
- pandas Documentation. Working with Missing Data. — Python ilə çatışmayan məlumatların aşkar edilməsi və emal üsulları.
- https://pandas.pydata.org/docs/user_guide/missing_data.html